Разобрать PDF-пачку на отдельные документы
DocJev извлекает текст страниц, а Jev определяет категорию документа и границы между вложениями. OCR и итоговая сборка PDF остаются отдельными этапами.
Что это решает
DocJev принимает PDF, DOCX или PPTX, извлекает текст страниц и определяет категории и границы отдельных документов. Jev делает содержательное решение; чтение файла, OCR и экспорт частей выполняют другие компоненты.
Классифицировать и разделить PDF, DOCX или PPTX
Почему разделить пачку сложнее, чем просто классифицировать страницы
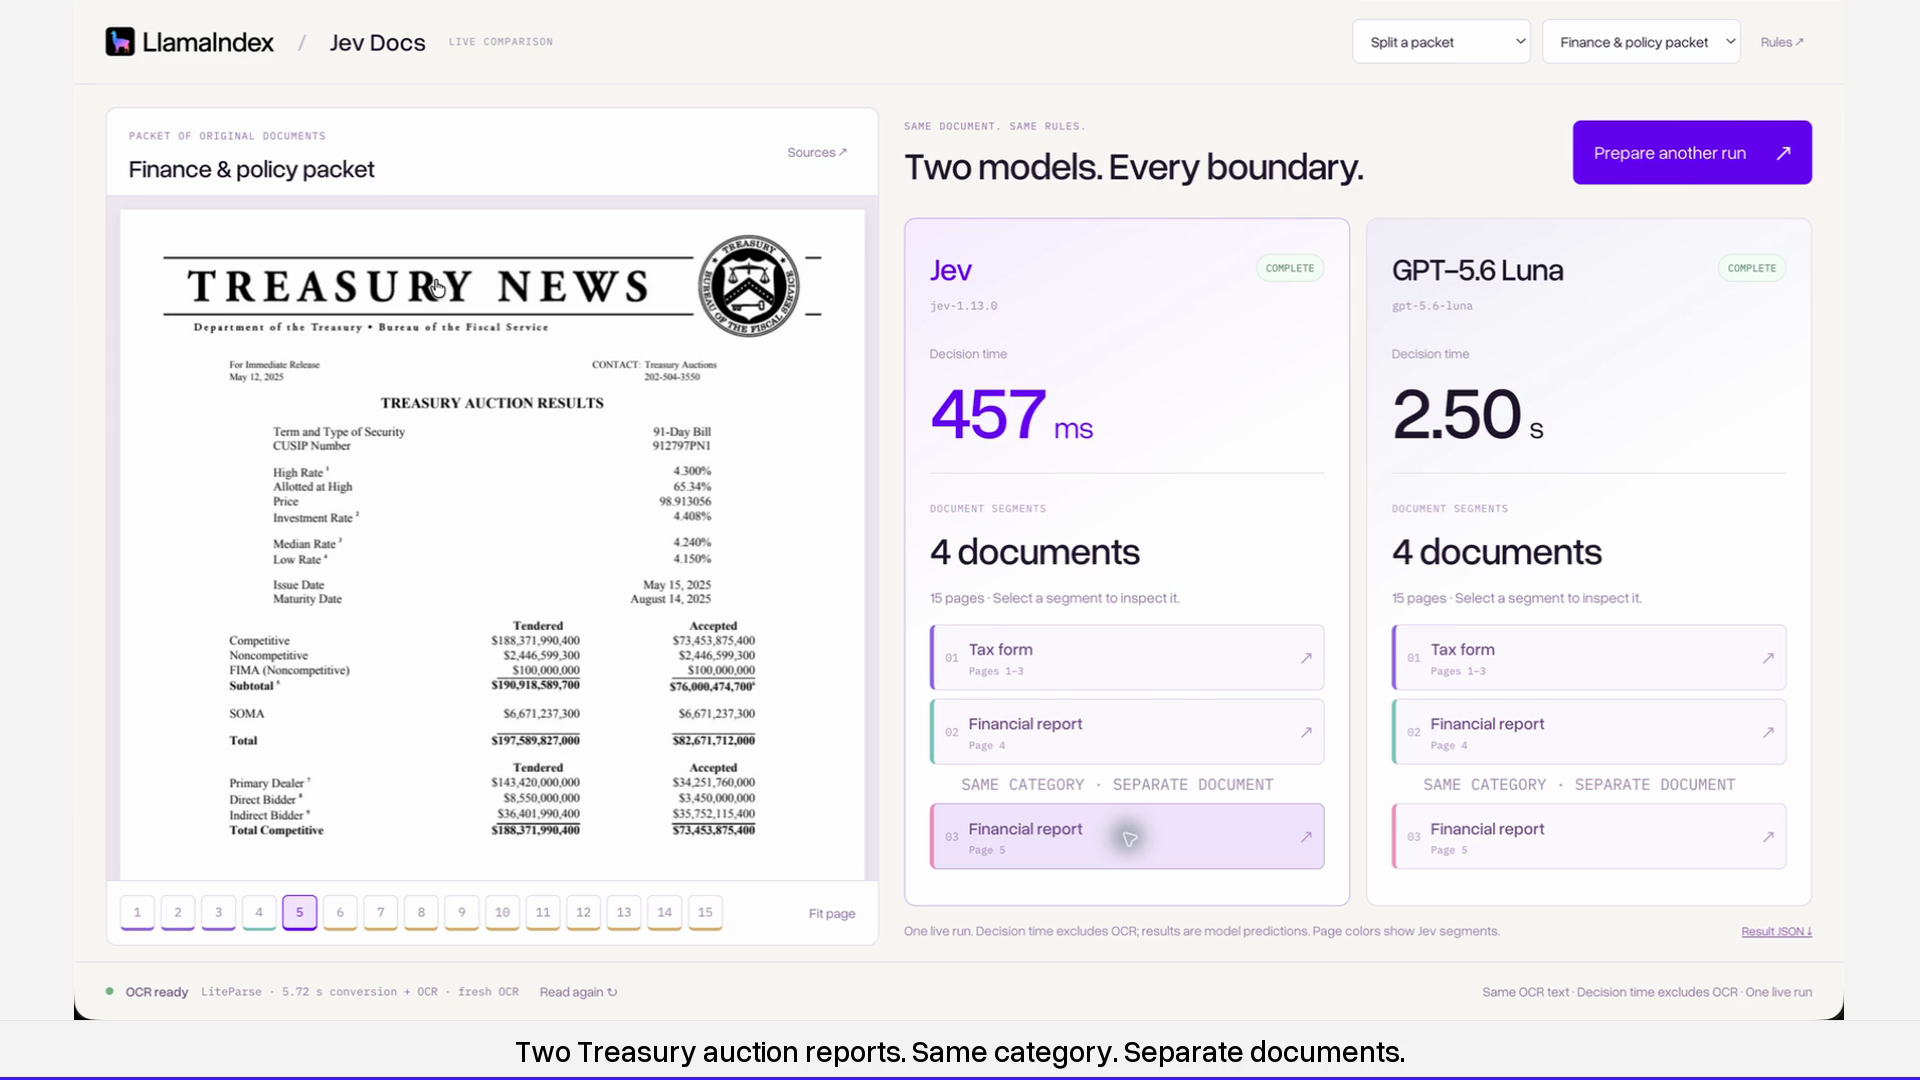
Два соседних документа могут относиться к одной категории. Поэтому смена ярлыка не может быть единственным сигналом границы. В опубликованном примере 15-страничного пакета рядом стоят два результата аукциона Treasury одной категории; DocJev разделяет их и сохраняет десятистраничный выпуск BEA целиком.
Правила категорий задаются обычным языком. Команда classify выдаёт категорию, вероятности и отметки для проверки, а split — упорядоченные диапазоны страниц. При необходимости результат можно экспортировать в отдельные PDF.
Где заканчивается локальная обработка
LiteParse извлекает текст страниц локально. Для сложных сканов можно включить облачный OCR через LlamaParse, но это дополнительная зависимость. Живые решения Jev всё равно требуют размещённого API: «локальное распознавание» не означает полностью офлайн-обработку.
DOCX и PPTX требуют LibreOffice для предварительного преобразования. Номера страниц относятся к полученному PDF-представлению, что стоит учитывать при проверке документа.
Что показал авторский пилот
В отдельном тесте на 40 оригинальных документах оба сравниваемых механизма классифицировали 40/40; Jev точно разделил 7 из 8 пакетов, модель сравнения — 8 из 8. Это ограниченная выборка, а не гарантированная точность для произвольных сканов и приложений.
Как попробовать самому
- 01Установить Python 3.11+ и зависимости репозитория через
uv sync. - 02Добавить TYPESAFE_API_KEY и начать с включённого примера
uv run docjev classify examples/real/originals/r04.pdf --rules examples/real/classify/rules.yaml. - 03Для составного пакета использовать
docjev splitи вручную проверить диапазоны страниц и спорные границы.
Ограничение этого проекта
Если документы содержат персональные или закрытые сведения, проверьте, что извлечённый текст можно отправлять внешнему API и выбранному OCR-провайдеру.